日本語プログラミングQ&Aの分析による
ローカル対話モデル構築に向けた基礎検討
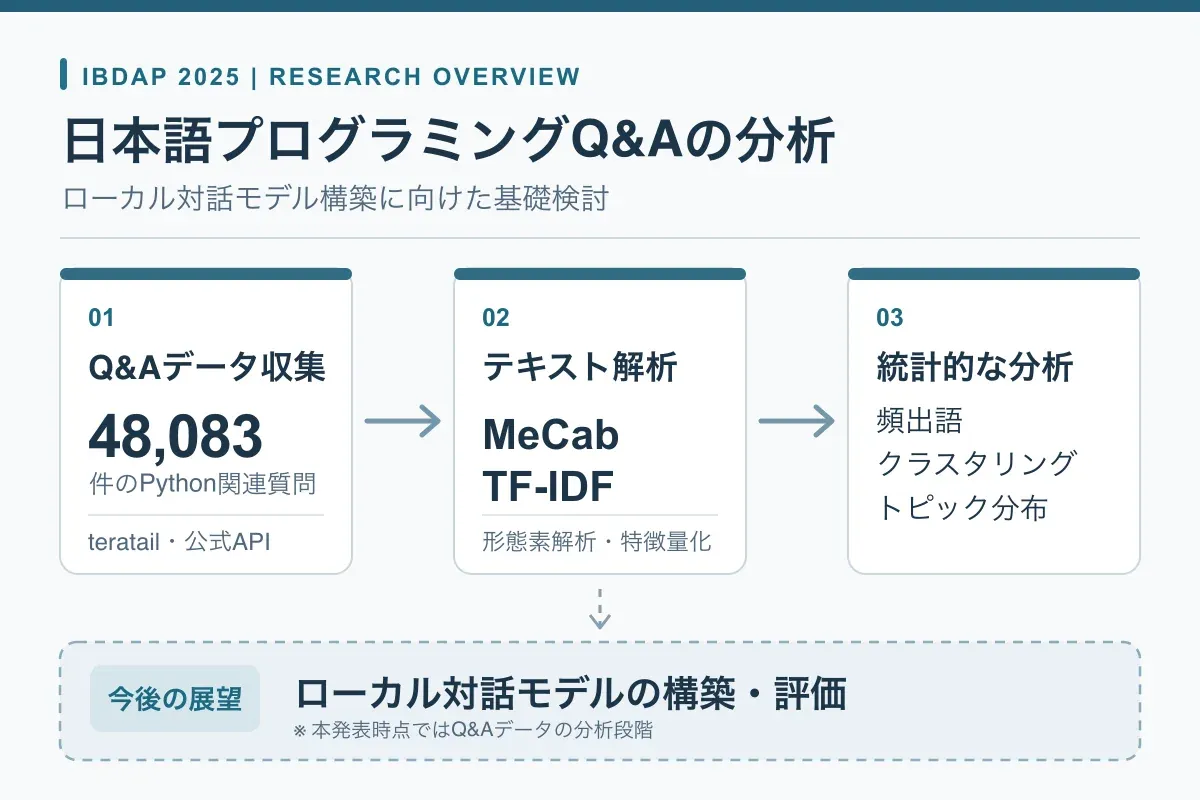
日本語のプログラミング質問応答データを分析し、学習者がつまずきやすい話題や質問内容の傾向を明らかにする研究です。teratailから収集したPython関連の質問48,083件を対象に、形態素解析、キーワード抽出、クラスタリング、トピックモデルを適用しました。得られた知見を、将来的なローカル環境で動作する学習支援用対話モデルの設計につなげます。
この研究のポイント
- teratailのPython関連質問48,083件を収集し、日本語のプログラミングQ&Aを分析
- MeCab・TF-IDF・K-means・DBSCAN・LDAを用い、頻出語、質問の類似性、話題分布を検討
- エラー対応や配列操作の話題を抽出するとともに、語彙に基づく習熟度推定の限界を確認
背景
日本では、2020年度から小学校でプログラミング教育が必修化され、2022年度には高等学校で「情報Ⅰ」が必履修科目となりました。さらに、2025年実施の大学入学共通テストには「情報」が導入されました。プログラミングを含む情報教育への関心が高まる一方、授業中の学習支援をどのように充実させるかが課題となっています。123
大学などのプログラミング演習では、学生が各自のペースで課題に取り組み、教員やティーチングアシスタント(TA)が質問への対応や巡回指導を行うことが一般的です。しかし、学生が挙手などによって困難を表明しない場合、教員が支援の必要性を把握することは容易ではありません。学習者の行き詰まりやプログラミング中の感情を捉えようとする先行研究もありますが、特に履修者数の多い授業では、限られた人数の教員がすべての学生に適時対応することは困難です。45
こうした状況に対し、対話型AIを活用した学習支援が期待されています。既存研究では、プログラミング課題へのAIフィードバックや教材の自動生成などが検討されています。67 一方、外部の商用クラウドサービスだけに依存する場合には、利用料金、仕様変更、ネットワーク接続、取り扱うデータの管理、実験の再現性などを考慮する必要があります。
そこで本研究では、日本語のプログラミング質問応答データを分析し、将来的にローカル環境で動作する学習支援用対話モデルを構築するための基礎的な知見を得ることに着目しました。本ページは、IBDAP 2025で発表したQ&Aデータ分析の成果を中心に紹介します。8
目的
本研究の長期的な目標は、日本語のプログラミングに関する質問に対応できる対話モデルを、特定の商用AIサービスに全面的に依存せず構築することです。演習中に学習者が疑問を解消する手段を増やし、教員による個別支援を補完することを目指します。
その第一段階として、国内のプログラミングQ&Aサイトに蓄積された質問・回答を分析し、以下の3点を調べました。
- つまずきの傾向:どのような語句や問題が質問に頻繁に現れるか。
- 質問内容と習熟度の関係:質問文の特徴から、初学者と経験者の違いを捉えられるか。
- 質問分野の分布:どの技術分野について質問が多く、時期によって話題がどう変化するか。
これらを把握することで、将来のファインチューニングや検索拡張生成(Retrieval-Augmented Generation: RAG)に利用するデータの整理、検索対象の選択、回答内容の調整に役立つ可能性があります。9
データと分析手法
データ収集と前処理
国内の技術系Q&Aサイトteratailの公式APIを利用し、Pythonタグを付けられた質問を収集しました。2025年3月22日時点で48,083件を取得しており、発表資料では同日時点のPythonタグ付き質問の**98.8%**に相当すると報告しています。質問本文や回答などのテキストを分析対象としました。8
日本語テキストの解析には形態素解析器MeCabを使用し、主に名詞・形容詞などを抽出しました。分析目的に応じて正規表現やストップワードによる除外処理を行い、各質問を語の特徴量に変換しました。なお、質問中のソースコードや記号、英語のエラーメッセージが分析上のノイズとなり得るため、前処理の改善余地も残されています。
分析の流れ
収集したデータに対し、次の3種類の分析を実施しました。
- TF-IDFを用いた語句分析:質問タイトル、本文、回答に現れる語句を抽出し、TF-IDFによる特徴量化と出現頻度の集計を行います。
- クラスタリング:質問文の特徴量にK-meansおよびDBSCANを適用し、似た質問をグループ化できるかを検証します。評価にはシルエット係数とCalinski–Harabasz(CH)指標を用います。
- LDAによるトピック分析:質問を10個の潜在的な話題に分類し、各トピックの件数と年次推移を調べます。
ここで得られるのは質問文の統計的な傾向であり、個々の質問者の習熟度や学習効果を直接測定した結果ではありません。
分析結果
1. 頻出語から見たプログラミング上のつまずき
質問タイトルの分析では、「エラー(Error)」が4,000回以上出現し、「方法(Method)」も上位に位置しました。ほかにも「ファイル」「データ」「表示」「画像」などの語が目立ち、実行時の不具合やデータ処理、画面表示に関する問題が多く投稿されていることがうかがえます。
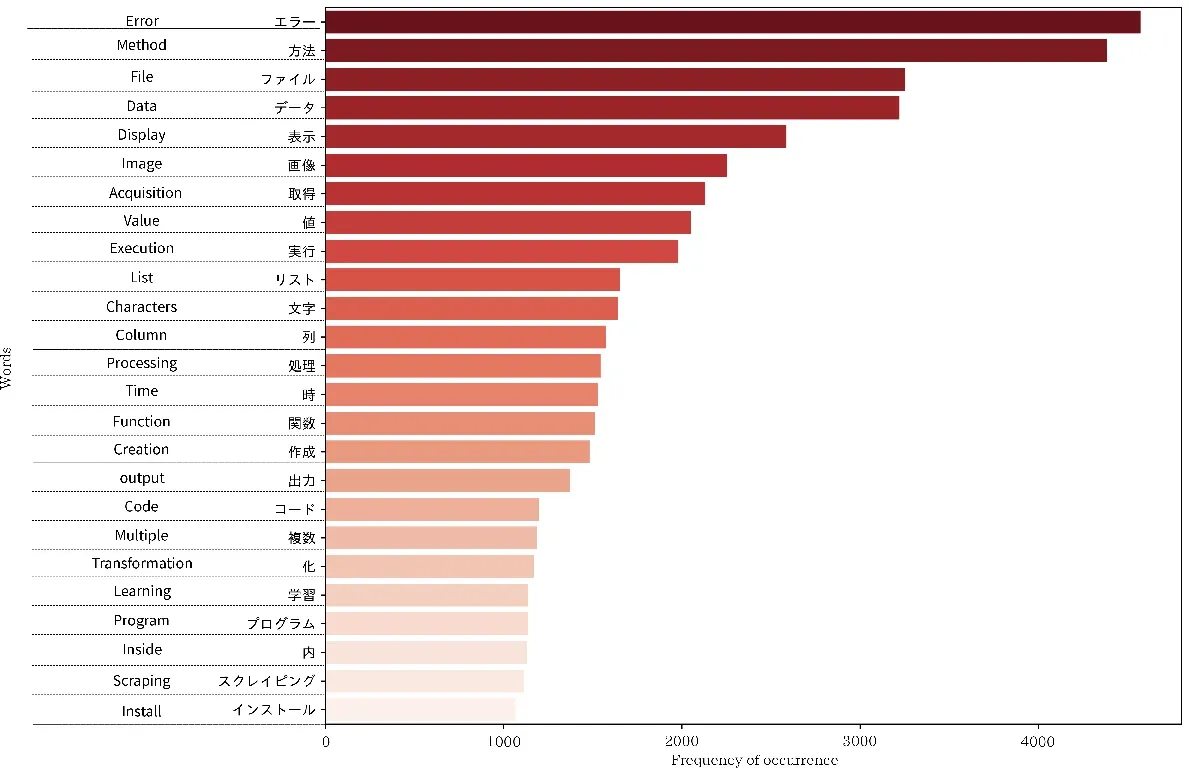
図1に示す「方法」は、Pythonのクラスやオブジェクトのメソッドだけを指すものではなく、問題を解決する「やり方」を尋ねる一般的な表現も含みます。したがって、上位語をそのまま技術カテゴリとみなすのではなく、質問の文脈と併せて解釈する必要があります。
この結果は、将来の対話モデルでエラーメッセージの説明、原因の切り分け、具体的な実装方法の案内を重視する際の手がかりになります。ただし、頻出語が多いこと自体は、特定の支援方法の有効性を保証するものではありません。
2. クラスタリングによる質問の分類
質問文をTF-IDFに基づく特徴量で表現し、K-meansおよびDBSCANによるクラスタリングを行いました。K-meansではクラスタ数を2~6、DBSCANではepsを複数の値に変更して評価しました。
表1:K-meansのクラスタリング評価(IBDAP 2025)
| クラスタ数 | シルエット係数 | CH指標 |
|---|---|---|
| 2 | 0.029 | 2616.693 |
| 3 | 0.005 | 1563.719 |
| 4 | 0.006 | 1192.070 |
| 5 | 0.006 | 958.213 |
| 6 | 0.007 | 815.045 |
表2:DBSCANのクラスタリング評価(IBDAP 2025)
| eps | クラスタ数 | シルエット係数 | CH指標 |
|---|---|---|---|
| 0.3 | 14 | -0.281 | 31.749 |
| 0.5 | 32 | -0.254 | 38.517 |
| 0.7 | 89 | -0.238 | 24.208 |
| 0.9 | 234 | -0.236 | 10.783 |
| 1.1 | 1 | 算出不可 | 算出不可 |
K-meansでは、検討した範囲でクラスタ数2の場合にシルエット係数が最大となりましたが、その値は0.029にとどまりました。DBSCANのシルエット係数も、評価可能な設定ではすべて負の値となりました。上記の表1・表2から、今回の特徴量だけでは質問群の明瞭な分離が難しいことが分かります。
K-meansで2クラスタに分けた際の中心語には、次の傾向が見られました。
- クラスタ0:「エラー」「コード」「データ」「画像」「エラーメッセージ」など。エラーの発生や解消に関する質問が目立ちました。
- クラスタ1:「コード」「ファイル」「実行」「入力」「データ」「表示」など。ファイル操作や入出力など、実装上の問題に関する質問が目立ちました。
これらは、初学者が遭遇しやすい問題と、ある程度経験のある利用者が扱う実装上の問題に関連する可能性があります。しかし、クラスタ同士の特徴は重複しており、クラスタ番号をそのまま質問者の習熟度ラベルとして使用できる段階ではありません。
3. LDAによる質問の話題分析
LDA(Latent Dirichlet Allocation)を用いて質問を10トピックに分類し、それぞれの代表語と質問件数を調べました。8
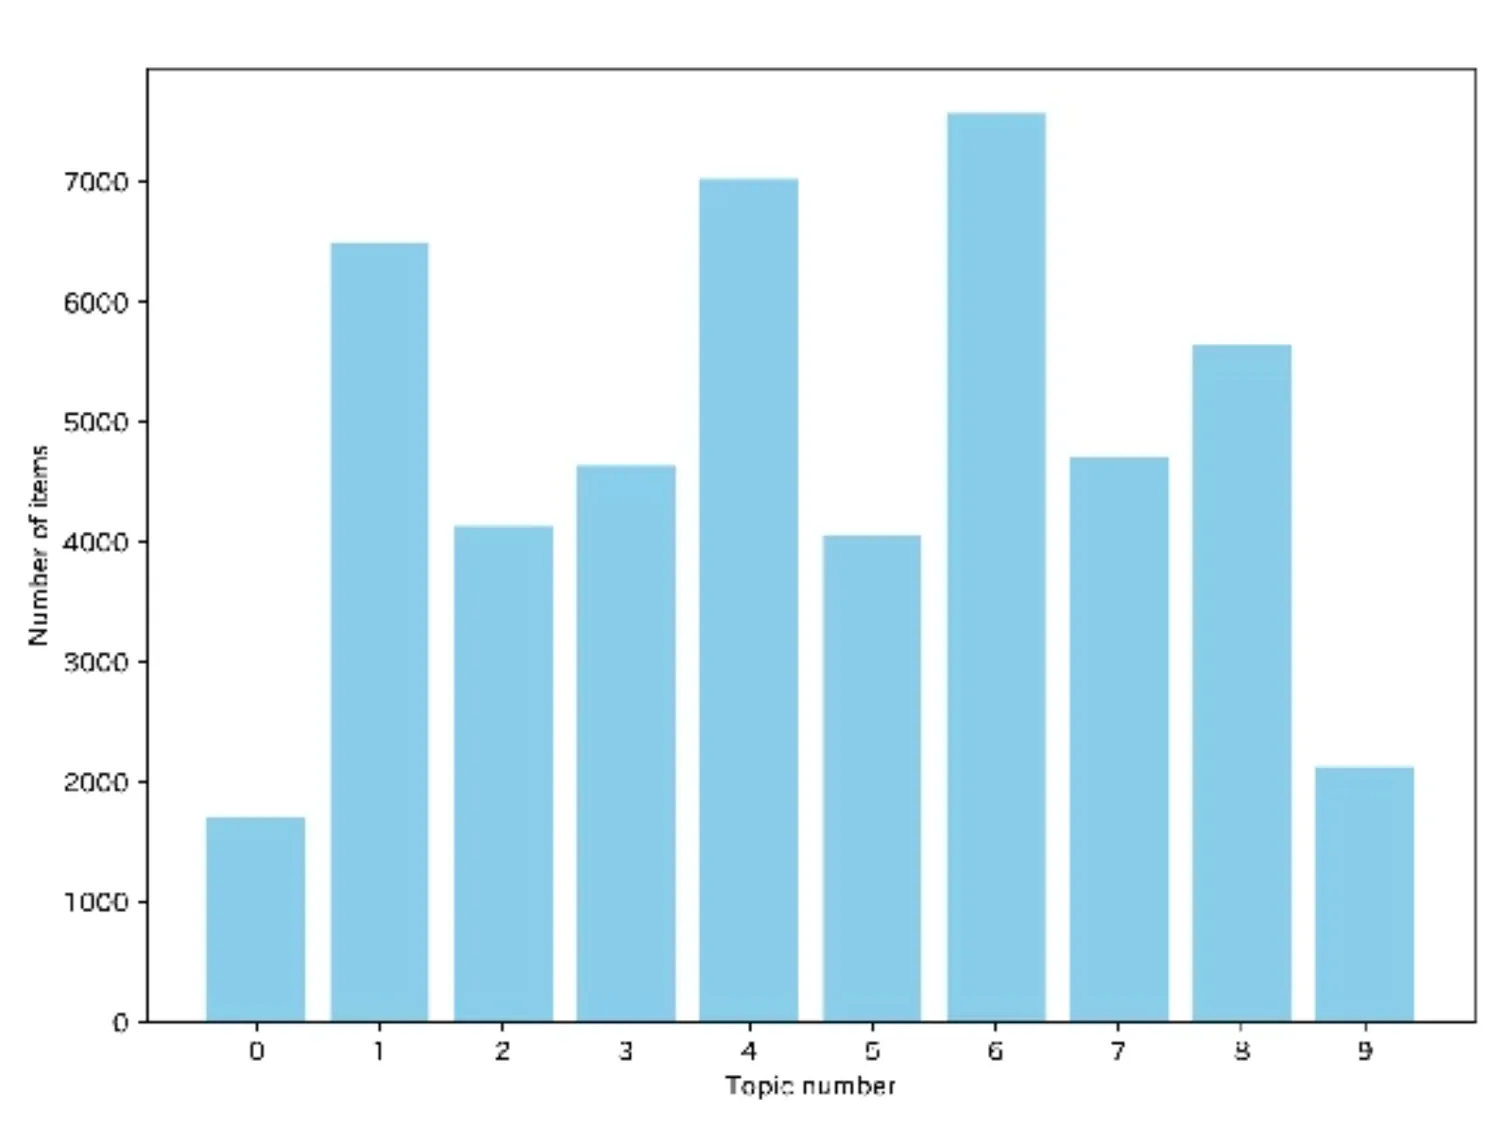
図2では、特にトピック1・4・6に多くの質問が割り当てられました。代表語からは、おおむね次の話題が読み取れます。
| トピック | 代表的な語 | 解釈される主な話題 |
|---|---|---|
| 1 | エラー、実行、コード、インストール、解決 | エラーへの対処 |
| 4 | リスト、関数、要素、配列、変数 | リスト・配列の操作 |
| 6 | 情報、ソース、問題、エラーメッセージ | エラーの詳細説明・原因の特定 |
トピック番号はLDAが付与した識別子であり、難易度の順位ではありません。また、「コード」「実行」のように複数トピックで共通する語も多く、カテゴリ間の違いをより明確にするには特徴語の選定を改善する必要があります。
質問件数を年次別に可視化すると、対象データでは2020~2021年頃に質問が多く、その後は減少する傾向が見られました。
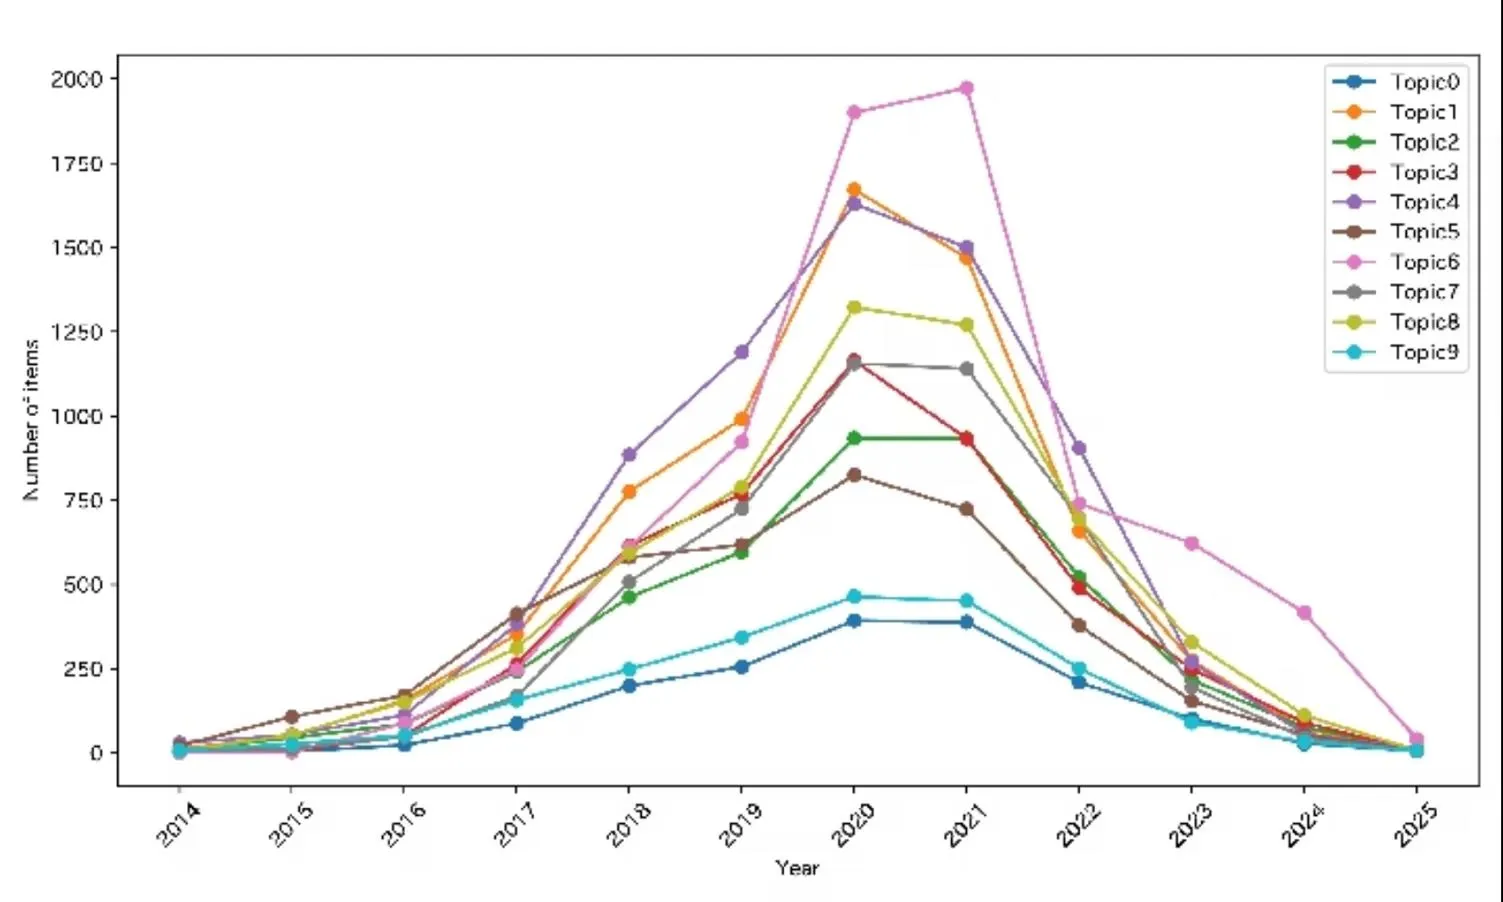
なお、2025年のデータは3月22日時点までの途中集計であり、過去の通年データとは直接比較できません。
ただし、この推移の原因を本分析だけで特定することはできません。プログラミング言語の普及、Q&Aサイトの利用状況、学習方法の変化など、複数の要因が考えられます。質問数の減少を生成AIの普及によるものと断定しないことが重要です。
考察と限界
今回の分析から、日本語のPython関連Q&Aではエラー解決や基本的なデータ操作に関する質問が目立つことが確認できました。こうした話題を優先的に扱う知識ベースは、学習支援用の対話システムを設計するうえで有用な候補になります。
一方で、次の制約があります。
- 質問者の習熟度を確定できない:クラスタリングの分離性能が低く、質問文の語彙だけで初学者・経験者を安定して区別できたとはいえません。
- コードと自然言語が混在する:ソースコード、記号、英語のエラーメッセージなどが形態素解析や特徴量抽出に影響します。
- トピックの妥当性に追加検証が必要:LDAによる分類は代表語に基づいて解釈したものであり、トピックの一貫性を定量評価する余地があります。
- 授業場面での有効性は未検証:公開Q&Aサイトの投稿者と、授業中の学習者は必ずしも同じ集団ではありません。実際の授業への適用と教育効果の検証は今後の課題です。
本発表で実施したのはQ&Aデータの収集・分析です。ローカルLLMのファインチューニングやRAGを組み込んだ対話システムの学習効果を実証したものではありません。
今後の展望
今後は、ソースコード部分の扱いを含む前処理の改善、BERTなどの文脈を考慮したテキスト表現の利用、クラスタリング手法の再検討、LDAのトピック一貫性の評価を進めます。
そのうえで、今回のデータ分析から得られた知見を、ファインチューニングやRAGによる日本語プログラミング支援用対話モデルの構築に活用することを検討します。例えば、エラー関連の質問には適切な解説や技術文書を検索し、質問内容に応じて回答の詳しさを調整する仕組みが考えられます。
最終的には、学内LANなどのローカル環境で利用できる軽量な対話システムを開発し、応答品質、処理時間、実際のプログラミング演習での使いやすさなどを検証することを目標としています。
発表情報
- 発表題目:Analysis of question-posting websites for building dialogue models specific to programming contexts
- 著者:Tadashi Ohara, Tomonori Hashiyama
- 会議:The 6th International Conference on Big Data Analytics and Practices(IBDAP 2025)
- 研究助成:JST SPRING, Grant Number JPMJSP2131
参考文献
-
文部科学省, 小学校プログラミング教育の手引(第三版), 2020. https://www.mext.go.jp/content/20200218-mxt_jogai02-100003171_002.pdf ↩
-
文部科学省, 高等学校学習指導要領(平成30年告示)解説 情報編, 2018. https://www.mext.go.jp/content/1407073_11_1_2.pdf ↩
-
文部科学省, 「令和4年度からの新高等学校学習指導要領の着実な実施に向けた高等学校情報科担当教員の採用・配置の促進・専門性の向上について(概要)」, 2021. https://www.mext.go.jp/content/000166301.pdf ↩
-
H. Oka, A. Ohnishi, T. Terada, and M. Tsukamoto, “System for Detecting Learner Stuck in Programming Learning,” Sensors, 23, 2023. https://doi.org/10.3390/s23125739 ↩
-
Z. Atiq and M. Loui, “A Qualitative Study of Emotions Experienced by First-year Engineering Students during Programming Tasks,” ACM Transactions on Computing Education, 22, pp. 1–26, 2022. https://doi.org/10.1145/3507696 ↩
-
E. Frankford, C. Sauerwein, P. Bassner, S. Krusche, and R. Breu, “AI-Tutoring in Software Engineering Education,” ICSE-SEET ’24, pp. 309–319, 2024. https://doi.org/10.1145/3639474.3640061 ↩
-
I. Pesovski, R. Santos, R. Henriques, and V. Trajkovik, “Generative AI for Customizable Learning Experiences,” Sustainability, 2024. https://doi.org/10.3390/su16073034 ↩
-
T. Ohara and T. Hashiyama, “Analysis of question-posting websites for building dialogue models specific to programming contexts,” 2025 6th International Conference on Big Data Analytics and Practices (IBDAP), IEEE, pp. 94–99, 2025. https://doi.org/10.1109/IBDAP65587.2025.11145742 ↩ ↩2 ↩3
-
P. Lewis et al., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,” Advances in Neural Information Processing Systems, 33, pp. 9459–9474, 2020. ↩